
Sikkerhed
Bag om Controlas model for cyberrisiko
2025-11-13
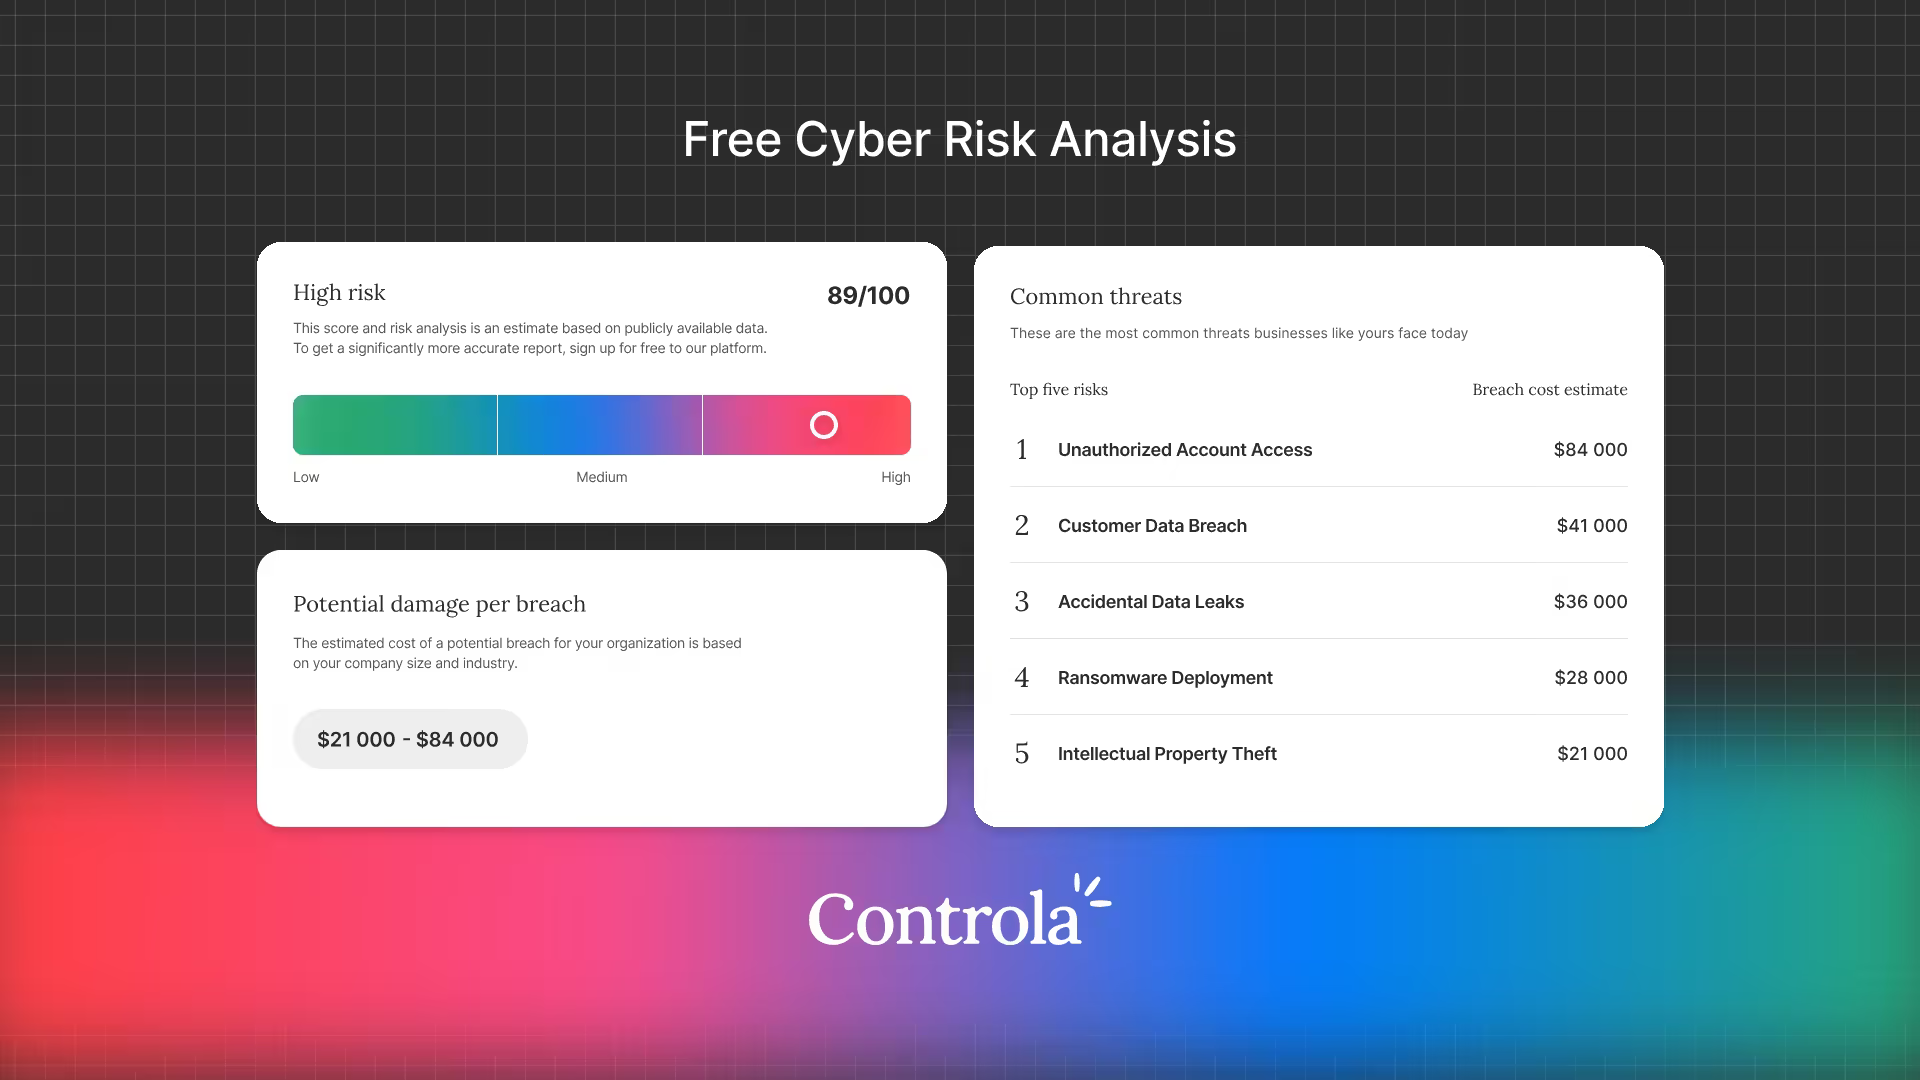
Efter min mening fejler de fleste risikovurderinger, fordi de bliver for vage eller abstrakte. Struktur og klare definitioner hjælper, men vi ville gå mere grundlæggende til værks ved at kombinere Cyber Risk Quantification (CRQ) med angrebstræer.
På vores platform bruger vi angrebstræer til at beskrive de faktiske trin i et angreb og lægger derefter et statistisk lag ovenpå. Her gennemgår jeg teknikken bag, fra bayesianske netværk til Monte Carlo-simuleringer, og viser, hvordan vi sætter tal på cyberrisiko.
Kernen: et bayesiansk netværk af angreb
I centrum af vores risikomotor ligger et bayesiansk netværk. Det er i praksis en rettet acyklisk graf (DAG), som forbinder hændelser, kaldet noder, med årsagssammenhænge, kaldet kanter.
Hver node repræsenterer en bestemt hændelse i angrebskæden, fx:
- "Phishingmail leveret"
- "Loginoplysninger stjålet"
- "Enhed kompromitteret"
- "Data ført ud af systemet"
Hver forbindelse beskriver en betinget sandsynlighed: Hvis ét trin lykkes, hvor stor er så sandsynligheden for, at det næste også gør?
Strukturen giver flere væsentlige fordele:
- Gennemsigtighed: Du kan følge et resultat tilbage gennem grafen og se præcis, hvilke sandsynligheder der har ført til det.
- Fleksibilitet: Når nye angrebsteknikker opstår, kan vi tilføje eller opdatere noder uden at skulle bygge hele modellen om.
Et enkelt eksempel: Antag, at sandsynligheden for et vellykket phishingforsøg er 20 %, og at der derefter er 60 % sandsynlighed for, at loginoplysninger bliver stjålet. Den samlede sandsynlighed for begge hændelser er så 12 %.
Udvid det til snesevis af noder med hver deres usikkerhedsinterval, og det bliver hurtigt tydeligt, at beregningen kræver mere end en serviet og en kuglepen. Samspillet bliver så komplekst, at der skal betydelig regnekraft til.
Sikkerhedstiltagene indgår i samme netværk. Hvert tiltag forbindes med en lavere sandsynlighed for, at en eller flere hændelser indtræffer. Fx:
- Multifaktorgodkendelse (MFA) mindsker sandsynligheden for, at phishing efter adgangskoder og lækkede adgangskoder fører til sikkerhedsbrud.
- Endpoint Detection and Response (EDR) mindsker sandsynligheden for, at angriberen kan bevare adgangen eller bevæge sig videre i netværket.
På den måde beskriver vi beskyttelse i flere lag, også kaldet "defense in depth", matematisk. Et tiltag, der påvirker flere led i en angrebskæde, får sin samlede effekt medregnet på tværs af angrebsfladen.
Usikkerhed beskrevet med betafordelingen
Hver hændelse i grafen rummer usikkerhed. Vi kan ikke bare sige: "Sandsynligheden for, at phishing lykkes, er præcis 17,3 %." Så enkelt er det ikke i virkeligheden.
Derfor bruger vi en betafordeling til at beskrive hver sandsynlighed som en række mulige værdier, vægtet efter hvor sikre vi er på datagrundlaget. Det giver en ærlig beskrivelse af både vores viden og det, vi ikke ved.
Ofte har vi data at støtte os til. Måske har vi set mange angreb, men endnu ingen vellykkede sikkerhedsbrud. Her kan vi fx bruge Laplaces successionsregel til at justere vores startantagelser, også kaldet priorer, på en statistisk forsvarlig måde.
Økonomiske konsekvenser med lognormalfordelingen
Når angrebskæden når en konsekvensnode, fx "systemer krypteret" eller "kundedata lækket", skal vi anslå omkostningen.
Tab ved cyberhændelser har en særlig fordeling: De fleste er små, men enkelte er ekstremt store. Derfor bruger vi en lognormalfordeling til at beskrive den økonomiske påvirkning.
Den indfanger naturligt den "lange hale": mange små tab og en lille sandsynlighed for meget store tab. Vi fastlægger parametrene ud fra empiriske data, fx:
- Branchegennemsnit
- Rapporter om omkostninger ved sikkerhedsbrud
- Sektorspecifikke justeringer
Monte Carlo-simuleringen
Vi står nu med et stort, komplekst bayesiansk netværk fyldt med sandsynlighedsfordelinger og omkostningsintervaller. Der findes ikke en enkel, lukket formel, som kan løse det hele.
I stedet bruger vi en Monte Carlo-simulering til at undersøge mulige udfald. Hver simulering følger omtrent disse trin:
- Vi trækker en sandsynlighed for hver hændelse fra dens betafordeling.
- Vi gennemløber angrebsgrafen og lader hændelser indtræffe eller udeblive ud fra de trukne sandsynligheder.
- Hvis en konsekvensnode bliver udløst, trækker vi et tab fra dens lognormalfordeling.
- Vi gemmer det samlede tab for den enkelte simulering.
Det gentages tusindvis af gange. Tilsammen danner resultaterne en samlet tabsfordeling.
Ud fra den kan vi fx beregne:
- Det forventede årlige tab
- Percentiler, fx 95. percentil, der beskriver tab i de dårlige år
- Conditional Value at Risk (CVaR), som viser det gennemsnitlige tab i de allerværste scenarier
Datakilder og priorer
En model bliver aldrig bedre end sit datagrundlag. Vi bygger derfor troværdige priorer til vores betafordelinger ved at kombinere empiriske data med anerkendte brancheundersøgelser.
Vi bruger blandt andet:
- Verizon Data Breach Investigations Report (DBIR) til angrebsfrekvens og -mønstre
- Data fra IRIS og Cyentia Institute til tabsniveauer og adfærd i fordelingens hale
Når kompleksitet gør det enklere
Det bedste ved al denne kompleksitet er, at brugeren ikke behøver forholde sig til den.
På platformen ser du konkrete beløb, du kan bruge til at træffe beslutninger. Matematikken bag er kompleks, men det er netop den, der gør resultaterne mere tilgængelige.
Traditionelle risikomatricer med uklare niveauer som "høj", "mellem" og "lav" overlader det til beslutningstagere uden teknisk baggrund selv at fortolke betydningen. Her får de noget håndgribeligt.
En økonomidirektør forstår, hvad 5 % sandsynlighed for et tab på 2 millioner kroner betyder. Det kan sammenlignes direkte med virksomhedens andre risici.
Det er styrken ved denne tilgang: Tallene kan underbygges, og de formidler risiko på et sprog, som hele organisationen kan forstå og handle på.
Skrevet af
Niklas Volcz, CPO
Niklas er udvikler og cybersikkerhedsekspert med mere end ti års erfaring inden for både teknisk og strategisk sikkerhed. Han drives af nysgerrigheden efter at analysere systemer og skille dem ad for at finde sårbarheder. Den nysgerrighed har han gennem hele sin karriere brugt til at skabe robuste sikkerhedsløsninger.