
Sikkerhet
Bak kulissene i Controlas cyberrisikomodell
2025-11-13
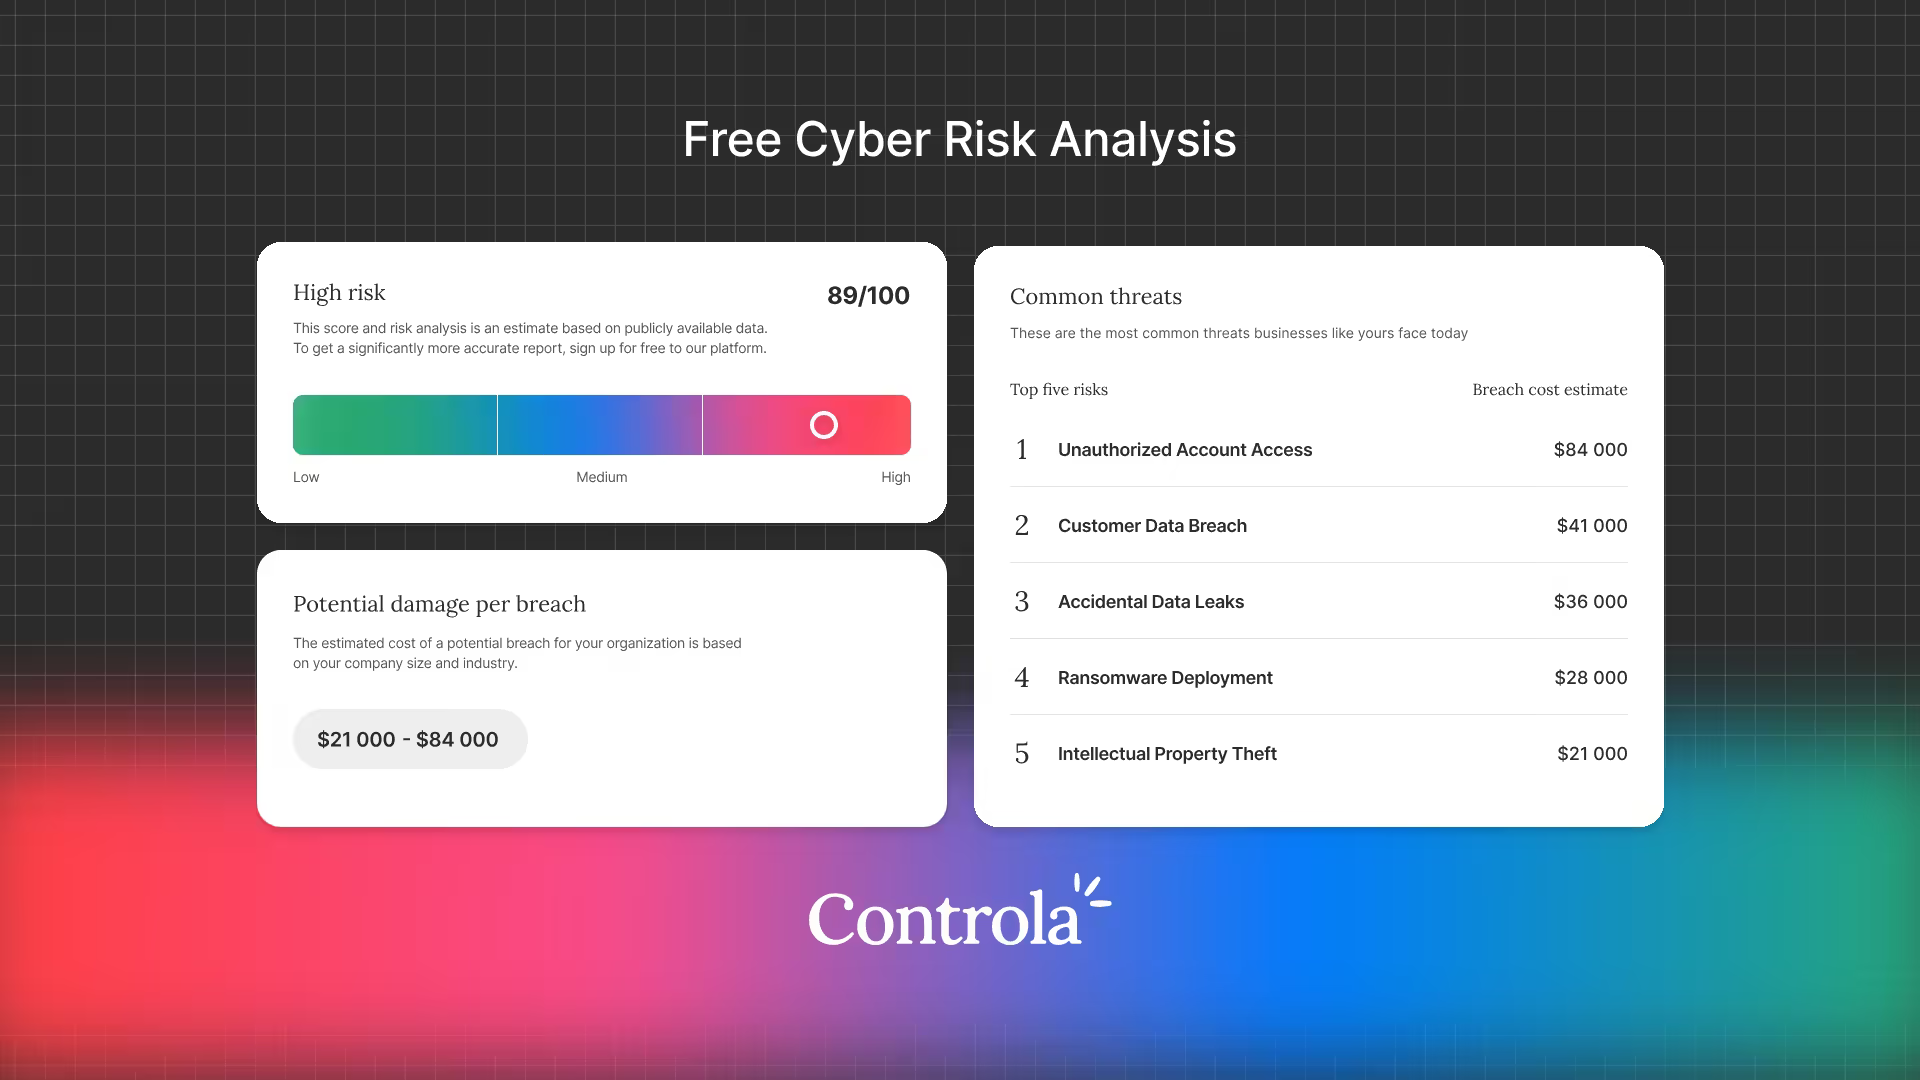
Jeg synes de fleste risikovurderinger svikter fordi de enten er for vage eller for abstrakte. Struktur og tydelige definisjoner hjelper, men vi ville løse problemet fra grunnen av ved å kombinere Cyber Risk Quantification (CRQ) med angrepstrær.
I plattformen vår modellerer vi de faktiske stegene i et angrep ved hjelp av angrepstrær og legger deretter et statistisk lag oppå. I denne teksten går jeg gjennom teknologien som gjør dette mulig – fra bayesianske nettverk til Monte Carlo-simuleringer – og viser hvordan vi tallfester cyberrisiko.
Kjernen: Et bayesiansk nettverk av angrep
I sentrum av risikomotoren vår finnes et bayesiansk nettverk, i praksis en rettet asyklisk graf (DAG) som kobler sammen hendelser (noder) og årsakssammenhengene mellom dem (kanter).
Hver node representerer en bestemt hendelse i angrepskjeden – for eksempel:
- «Nettfiskingsmelding levert»
- «Innloggingsopplysninger stjålet»
- «Endepunkt kompromittert»
- «Data hentet ut»
Hver kobling definerer en betinget sannsynlighet: Hvis ett steg lykkes, hvor stor er sjansen for at det neste også gjør det?
Denne strukturen har flere viktige fordeler:
- Åpenhet – Du kan spore et resultat bakover gjennom grafen og se nøyaktig hvilke sannsynligheter som førte til det.
- Tilpasningsevne – Når nye angrepsteknikker dukker opp, kan vi legge til eller oppdatere noder uten at hele modellen bryter sammen.
Et enkelt eksempel: Si at nettfisking har 20 % sannsynlighet for å lykkes, og at sannsynligheten for at innloggingsopplysninger blir stjålet er 60 % hvis nettfiskingen lykkes. Den samlede sannsynligheten for begge hendelsene blir da 12 %.
Skaler opp den samme logikken til flere titalls noder, hver med sine egne usikkerhetsintervaller, så ser man raskt at dette ikke kan regnes ut på baksiden av en konvolutt. Samspillet blir så komplekst at det krever betydelig regnekraft.
Sikkerhetstiltakene er også bygget inn i det samme nettverket. Hvert tiltak knyttes til en reduksjon i sannsynligheten for at én eller flere noder lykkes. For eksempel:
- Multifaktorautentisering (MFA) reduserer sannsynligheten for at nettfisking etter passord og lekkede passord fører til innbrudd.
- Endpoint Detection and Response (EDR) reduserer sannsynligheten for at angripere beholder tilgangen eller beveger seg videre mellom systemer.
Slik fanger vi «forsvar i dybden» matematisk. Et tiltak som påvirker flere steg i en angrepskjede, viser sin samlede verdi over hele angrepsflaten, i stedet for bare å telles én gang isolert.
Å modellere usikkerhet med betafordelingen
Hver hendelse i grafen – hvert ledd i angrepskjeden – inneholder usikkerhet. Vi kan ikke bare si: «Sannsynligheten for at nettfisking lykkes, er nøyaktig 17,3 %.» Virkeligheten fungerer ikke slik.
I stedet bruker vi en betafordeling for å beskrive hver sannsynlighet som et intervall av mulige verdier, vektet etter hvor sikre vi er på dataene. Det gjør at vi kan modellere kunnskapen vår (og det vi ikke vet) på en ærlig måte.
I mange tilfeller har vi også data å støtte oss på. Vi kan ha observert mange angrep, men ingen vellykkede innbrudd ennå. Da kan vi for eksempel bruke Laplaces suksesjonsregel for å justere startantakelsene våre – priorene våre – på en statistisk korrekt måte.
Økonomiske konsekvenser med lognormalfordelingen
Når angrepskjeden når en konsekvensnode – for eksempel «systemer kryptert» eller «kundedata lekket» – må vi anslå kostnaden.
Cyberhendelser har en spesiell tapsfordeling: De fleste tapene er små, men noen få er ekstremt store. Derfor bruker vi en lognormalfordeling for de økonomiske konsekvensene.
Lognormalfordelingen fanger naturlig denne «lange halen» – mange små tap og en liten sannsynlighet for svært store tap. Vi setter parametrene ved hjelp av empiriske data, for eksempel:
- Bransjegjennomsnitt
- Rapporter om kostnader ved innbrudd
- Sektorspesifikke justeringer
Monte Carlo-simuleringen
Vi har altså et stort, komplekst bayesiansk nettverk fullt av sannsynlighetsfordelinger og kostnadsintervaller. Det finnes ingen enkel, lukket formel for å bare «løse» alt.
Her bruker vi i stedet en Monte Carlo-simulering for å utforske alle mulige utfall. Hver simulering følger i grove trekk disse stegene:
- Vi trekker en sannsynlighet for hver hendelse fra betafordelingen dens.
- Vi går gjennom angrepsgrafen og lar hendelser lykkes eller mislykkes basert på de trukne sannsynlighetene.
- Hvis en konsekvensnode utløses, trekker vi et tap fra lognormalfordelingen dens.
- Vi lagrer det totale tapet for akkurat den simuleringen.
Dette gjentas tusenvis av ganger. Til sammen danner resultatene en fullstendig tapsfordeling.
Ut fra den kan vi for eksempel beregne:
- Forventet årlig tap
- Persentiler (som den 95. persentilen – tap i «dårlige år»)
- Conditional Value at Risk (CVaR), som viser det gjennomsnittlige tapet i de aller verste scenarioene
Datakilder og priorer
En modell er selvsagt aldri bedre enn inndataene sine. For å bygge troverdige priorer til betafordelingene våre – startantakelsene våre – bruker vi en kombinasjon av empiriske data og etablerte bransjestudier.
Vi tar blant annet utgangspunkt i:
- Verizon Data Breach Investigations Report (DBIR) for hyppighet og mønstre i angrep
- Data fra IRIS og Cyentia Institute for tapsnivåer og fordelingens hale
Når kompleksitet gjør ting enklere
Det fine med all denne kompleksiteten er at den er usynlig for brukeren.
I plattformen ser du enkle pengebeløp å forholde deg til. Ja, matematikken under panseret er kompleks – men det er nettopp den som gjør metoden mer tilgjengelig.
Tradisjonelle risikomatriser med uklare nivåer som «høy», «middels» og «lav» tvinger beslutningstakere uten teknisk bakgrunn til selv å tolke hva det egentlig betyr. Her får du noe konkret.
En økonomidirektør forstår hva 5 % sannsynlighet for et tap på 2 millioner kroner betyr. Det kan sammenlignes direkte med andre forretningsrisikoer som allerede ligger på bordet.
Det er den virkelige styrken ved denne tilnærmingen. Det handler ikke bare om tall som kan forsvares – men om endelig å snakke et språk som hele organisasjonen kan forstå og handle ut fra.
Skrevet av
Niklas Volcz, CPO
Niklas er utvikler og cybersikkerhetsekspert med over ti års erfaring innen både teknisk og strategisk sikkerhet. Han motiveres av å analysere og plukke fra hverandre systemer for å finne sårbarheter, og har bygd karrieren sin på å bruke denne nysgjerrigheten til å skape robuste sikkerhetsløsninger.